AWS Bahrain: Offline-Backups und Multi-Vendor-Strategie als Resilienz-Lehre
Der AWS-Fall in Bahrain führt eine unbequeme Frage vor Augen: Was bleibt übrig, wenn nicht nur ein Server oder eine Availability Zone ausfällt, sondern eine ganze Cloud-Region nicht mehr zur Verfügung steht? Für Teams mit geschäftskritischen Videokonferenzen reicht es dann nicht, auf Redundanz innerhalb eines einzelnen Anbieters zu vertrauen. Entscheidend sind eigenständige Datenkopien, ein realistischer Wiederanlaufplan und ein Ausweichweg, der auch dann funktioniert, wenn das primäre Cloudkonto oder der primäre Anbieter nicht erreichbar ist.
AWS teilte am 15. September 2026 mit, dass der Zugriff auf Ressourcen und Daten nicht wiederhergestellt werden kann, sofern diese ausschließlich in der Region me-south-1 (Bahrain) gehostet waren. Mehrere Availability Zones waren betroffen; das Ereignis überschritt den Resilienzrahmen regionaler und Multi-AZ-Dienste. Der öffentlich wiedergegebene AWS-Health-Status und die AWS-Mitteilung zur Störung nennen Migration in andere Regionen sowie vorhandene Backups als mögliche Wege für betroffene Kunden.
Der Fall erlaubt keine pauschale Aussage über alle Daten oder Anwendungen in Bahrain. Entscheidend ist die Abgrenzung: Wer eine nutzbare Kopie außerhalb der Region hatte – etwa durch Replikation, ein Cross-Region-Backup oder eine frühere Migration –, ist nicht in derselben Ausgangslage wie ein Workload, dessen Ressourcen und Daten ausschließlich dort lagen. Der Reuters-Bericht ordnet die AWS-Statusaussage ebenfalls in diesem konkreten Rahmen ein.
Die zentrale Lehre: Ein Anbieter ist eine gemeinsame Fehlerdomäne
Multi-AZ bleibt sinnvoll. Availability Zones sind getrennte Standorte innerhalb einer Region; eine über mehrere Zonen verteilte Architektur kann den Ausfall einer einzelnen Zone abfedern. Bei einem regionsweiten, korrelierten Ereignis teilen diese Zonen jedoch weiterhin regionale Abhängigkeiten – und auch ein einzelnes Cloudkonto, dessen Zugänge, Policies oder Schlüssel nicht verfügbar sind, kann zum Engpass werden.
Für ein Szenario, in dem eine ganze Region oder der Zugang zum primären Anbieter ausfällt, braucht es daher mehr als Dienstzusagen und interne Anbieterredundanz. AWS beschreibt Multi-Region-Architekturen mit getrennten Datenkopien, Replikation und Recovery-Planung als Bausteine von Business Continuity und Disaster Recovery. Die AWS-Prescriptive-Guidance zu Multi-Region-Architekturen macht diese Trennung der Fehlerdomänen deutlich.
Die praktische Konsequenz: Unternehmen sollten festlegen, welche Dienste beim Ausfall ihres Hauptanbieters weiterlaufen müssen, welche Daten dafür gebraucht werden und welche Abhängigkeiten außerhalb dieses Anbieters erreichbar bleiben müssen. Das gilt besonders für Videokonferenzen, wenn Kommunikation, Termine, Identitäten oder Aufzeichnungen in einer Störung benötigt werden.
| Schutzfrage | Redundanz bei einem Anbieter | Getrennte Multi-Vendor-Strategie |
|---|---|---|
| Ausfall einer einzelnen Availability Zone | Multi-AZ ist dafür konzipiert | Kann ergänzen, ist aber nicht zwingend nötig |
| Ausfall einer ganzen Region | Zusätzliche Multi-Region-Planung nötig | Zweiter Anbieter oder selbstständig betreibbarer Zielstandort erweitert die Fehlerisolation |
| Ausfall des Cloudkontos oder zentraler Zugänge | Kann den Wiederanlauf blockieren | Unabhängige Identitäten, Schlüssel und Notfallzugänge reduzieren diese Abhängigkeit |
| Wiederherstellung von Daten | Abhängig von Kopie, Rechten und Anbieterzugriff | Eine getrennt verwaltete Kopie schafft einen zusätzlichen Wiederanlaufpfad |
Offline-Backups: Die Kopie muss vom Primärsystem getrennt sein
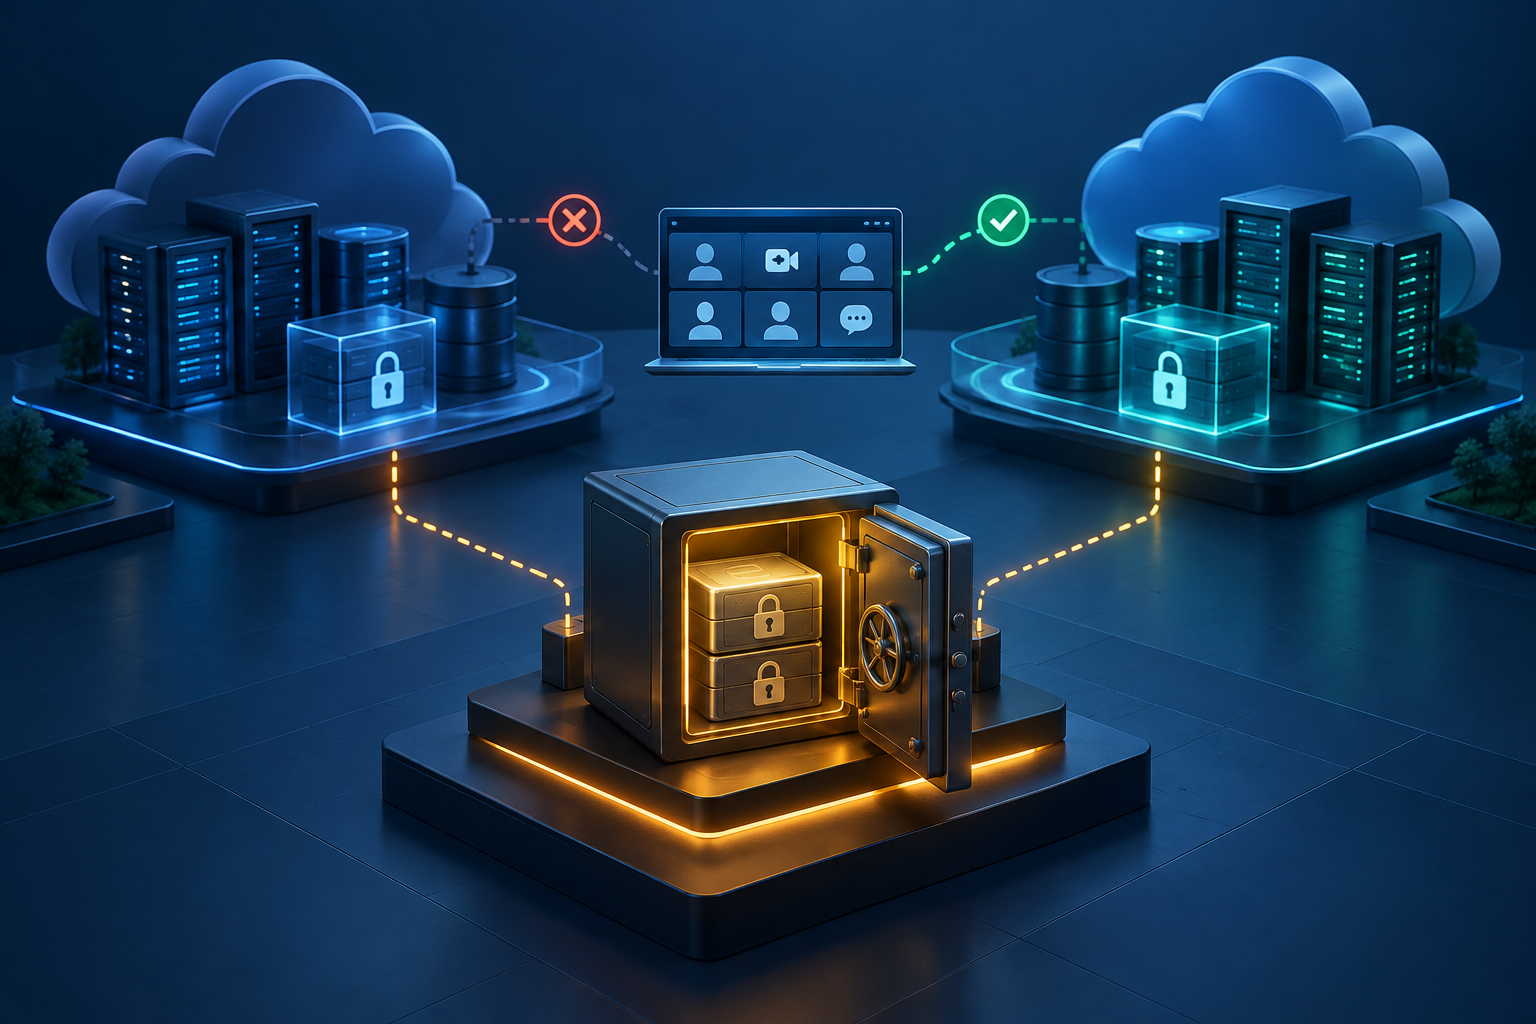
Ein Backup hilft nur, wenn es im Notfall erreichbar und wiederherstellbar ist. Eine Sicherung im selben Konto, in derselben Region oder unter denselben Berechtigungen wie der Primärbestand kann bei einem umfassenden Ausfall denselben Einschränkungen unterliegen. Deshalb gehört zu einem belastbaren Konzept mindestens eine Kopie, die vom primären Cloudkonto und vom primären Anbieter getrennt verwaltet wird.
Diese Trennung kann unterschiedliche Formen annehmen: ein unveränderbares Backup in einem separaten Sicherheitsbereich, ein exportierter Datenbestand bei einem zweiten Anbieter oder ein Offline-Archiv mit klar geregeltem Zugriff. Welche Variante passt, hängt von Datenmenge, Schutzbedarf, RPO und RTO ab. Entscheidend ist die Betriebsrealität: Das Recovery-Team braucht im Ernstfall Zugriff auf die Kopie, die benötigten Schlüssel, die technischen Werkzeuge und eine dokumentierte Reihenfolge für die Wiederherstellung.
AWS Backup kann Sicherungen planmäßig oder ad hoc in andere Regionen kopieren. Die AWS-Dokumentation zu Cross-Region-Backups weist zugleich darauf hin, dass Unterstützung und Grenzen je nach Ressource und Region variieren. Eine regionsübergreifende Kopie ist daher ein wichtiger Baustein, aber noch kein Ersatz für eine vom Primäranbieter getrennte Recovery-Option.
Ein praxistauglicher Backup-Check
Für jede kritische Datenklasse sollten Verantwortliche vier Fragen konkret beantworten können:
- Wo liegt die unabhängige Kopie – außerhalb der Primärregion, außerhalb des Primärkontos und, wenn erforderlich, außerhalb des Primäranbieters?
- Wer kann sie im Notfall mit separaten Identitäten und Schlüsseln erreichen?
- Welche Datenstand-Lücke ist zulässig (RPO), und wie lange darf der Wiederanlauf dauern (RTO)?
- Wann wurde die vollständige Wiederherstellung zuletzt unter realistischen Bedingungen getestet?
Ein grüner Backup-Job beantwortet keine dieser Fragen vollständig. Erst ein Wiederherstellungstest zeigt, ob Daten, Infrastruktur, Konfiguration, Schlüssel und Zugänge zusammen funktionieren.
Multi-Vendor ohne Komplexitätsfalle
Eine Multi-Vendor-Strategie bedeutet nicht, jede Anwendung doppelt bei zwei Hyperscalern zu betreiben. Das wäre teuer, schwer zu warten und kann neue Risiken erzeugen. Sinnvoll ist eine abgestufte Entscheidung nach Geschäftsrelevanz.
Für sehr kritische Funktionen kann ein vorbereiteter sekundärer Betriebsstand bei einem anderen Anbieter oder in einer unabhängig betreibbaren Umgebung gerechtfertigt sein. Für andere Systeme genügt es, Daten regelmäßig in ein getrenntes Archiv zu exportieren und Infrastruktur, Code sowie Konfiguration so vorzuhalten, dass sie im Zielsystem wieder aufgebaut werden können. AWS nennt beim Backup-and-Restore neben Daten ausdrücklich Infrastruktur, Code und Verkehrsumleitung als Teile des Wiederanlaufs. Die AWS-Well-Architected-Guidance zu Disaster Recovery beschreibt diese Abhängigkeiten.
Ein umsetzbarer Start sieht so aus:
- Kritische Services priorisieren. Welche Funktionen müssen binnen Stunden weiterlaufen, welche dürfen später zurückkehren?
- Abhängigkeiten sichtbar machen. Datenbanken, Identität, DNS, E-Mail, Schlüssel, Monitoring, CI/CD und externe APIs gehören in dieselbe Betrachtung wie die Anwendung.
- Portabilität vorbereiten. Datenexporte, dokumentierte Schnittstellen, Infrastrukturdefinitionen und getestete Wiederherstellungsabläufe verhindern, dass ein Wechsel erst im Krisenfall erlernt wird.
- Unabhängige Zugänge festlegen. Break-Glass-Konten, getrennte Schlüsselverwaltung und erreichbare Kontaktwege sind Teil der Technik, nicht nur der Organisation.
- Failover üben. Ein Test soll zeigen, ob der Dienst im Zielstandort innerhalb des vereinbarten RTO mit einem Datenstand innerhalb des RPO nutzbar ist.
Der Kern ist nicht maximale Vielfalt, sondern bewusst reduzierte gemeinsame Fehlerdomänen. Wer einen zweiten Weg plant, sollte ihn so einfach halten, dass das Team ihn auch unter Zeitdruck bedienen kann.
Was Videokonferenz-Teams konkret prüfen sollten
Videokonferenzsysteme verarbeiten mehr als laufende Audio- und Videoströme. Je nach Produkt und Konfiguration kommen Chat, Aufzeichnungen, Transkripte, Teilnehmer- und Nutzungsdaten, Metadaten, Einladungen, Identitäten, Protokolle und Supportdaten hinzu. Diese Datenklassen können unterschiedliche Speicher-, Backup- und Verarbeitungsorte haben.
Für die Bewertung einer Open-Source-Videokonferenz und digitalen Souveränität zählen deshalb nachvollziehbare Datenwege und betriebliche Wahlmöglichkeiten. Teams sollten insbesondere klären:
- Wo werden Medien, Chat, Aufzeichnungen, Transkripte, Metadaten und Logs verarbeitet und gespeichert?
- Welche Daten liegen als getrennte, wiederherstellbare Kopie vor – und wer kann darauf zugreifen?
- Wie bleiben Identitätsdienste, Verschlüsselungsschlüssel, DNS und Supportzugänge beim Ausfall des Primäranbieters verfügbar?
- Welche externen Dienste oder Subprozessoren sind für Betrieb und Recovery erforderlich?
- Welche RPO- und RTO-Ziele gelten je Datenklasse, und wann wurde der Notfallpfad zuletzt getestet?
Auch abgeschlossene Besprechungen gehören in diese Planung. Wer vergangene Videokonferenzen einsehen kann, sollte für die zugehörigen Informationen Speicherort, Aufbewahrung, Export und Wiederherstellung nachvollziehen können.
Europäisch und souverän: Nachweise statt Etiketten
Eine europäische oder souveräne Betriebsoption kann die Auswahl und Kontrolle von Standorten, Rechtsraum und Betriebsmodellen verbessern. Für Resilienz ersetzt sie jedoch keine technische Prüfung. Datenresidenz betrifft Speicher- und Verarbeitungsorte; Datensouveränität umfasst darüber hinaus Zugriffsrechte, Governance und rechtliche Einflüsse. AWS unterscheidet diese Begriffe in seiner Digital Sovereignty Lens. Auch die Europäische Kommission beschreibt Souveränität als abgestuftes, an Anforderungen gebundenes Konzept.
Bei Videokonferenzen sollten Beschaffungsteams daher Datenflüsse, Backup- und Wiederherstellungsorte, Schlüssel- und Identitätszugriffe, Supportwege, Subprozessoren, Exportmöglichkeiten und Notfalltests belegen lassen. Die entscheidende Frage lautet nicht nur, wo ein Dienst heute betrieben wird. Sie lautet auch: Wie lässt er sich weiterbetreiben oder wiederherstellen, wenn der bisherige Weg nicht mehr verfügbar ist?
Fazit: Wiederherstellbarkeit braucht einen unabhängigen Weg
AWS Bahrain zeigt die Grenze einer Resilienzplanung, die allein auf eine Region, ein Konto oder einen Anbieter zugeschnitten ist. Multi-AZ schützt gegen die Fehlerdomäne einzelner Zonen. Ein belastbarer Plan für größere Ausfälle ergänzt diese Stärke durch getrennte Datenkopien, klar definierte RPO/RTO-Ziele und einen getesteten Wiederanlauf.
Für kritische Videokonferenzen ist eine Multi-Vendor-Strategie dann sinnvoll, wenn sie reale gemeinsame Abhängigkeiten reduziert: mit Offline- oder separat verwalteten Backups, unabhängigen Zugängen und einem geübten Zielbetrieb. Nicht die Zahl der Anbieter schafft Resilienz, sondern ein nachweisbar nutzbarer Weg zurück zum Dienst.
Quellen
- AWS-Statusereignis Bahrain, öffentlich wiedergegeben
- AWS: Bahrain disrupted by ongoing conflict
- Reuters-Bericht via Insurance Journal
- AWS Prescriptive Guidance: Multi-Region Architecture
- AWS Backup: Cross-Region backup
- AWS Well-Architected: Disaster Recovery
- AWS Digital Sovereignty Lens
- Europäische Kommission: Cloud and AI Development Act